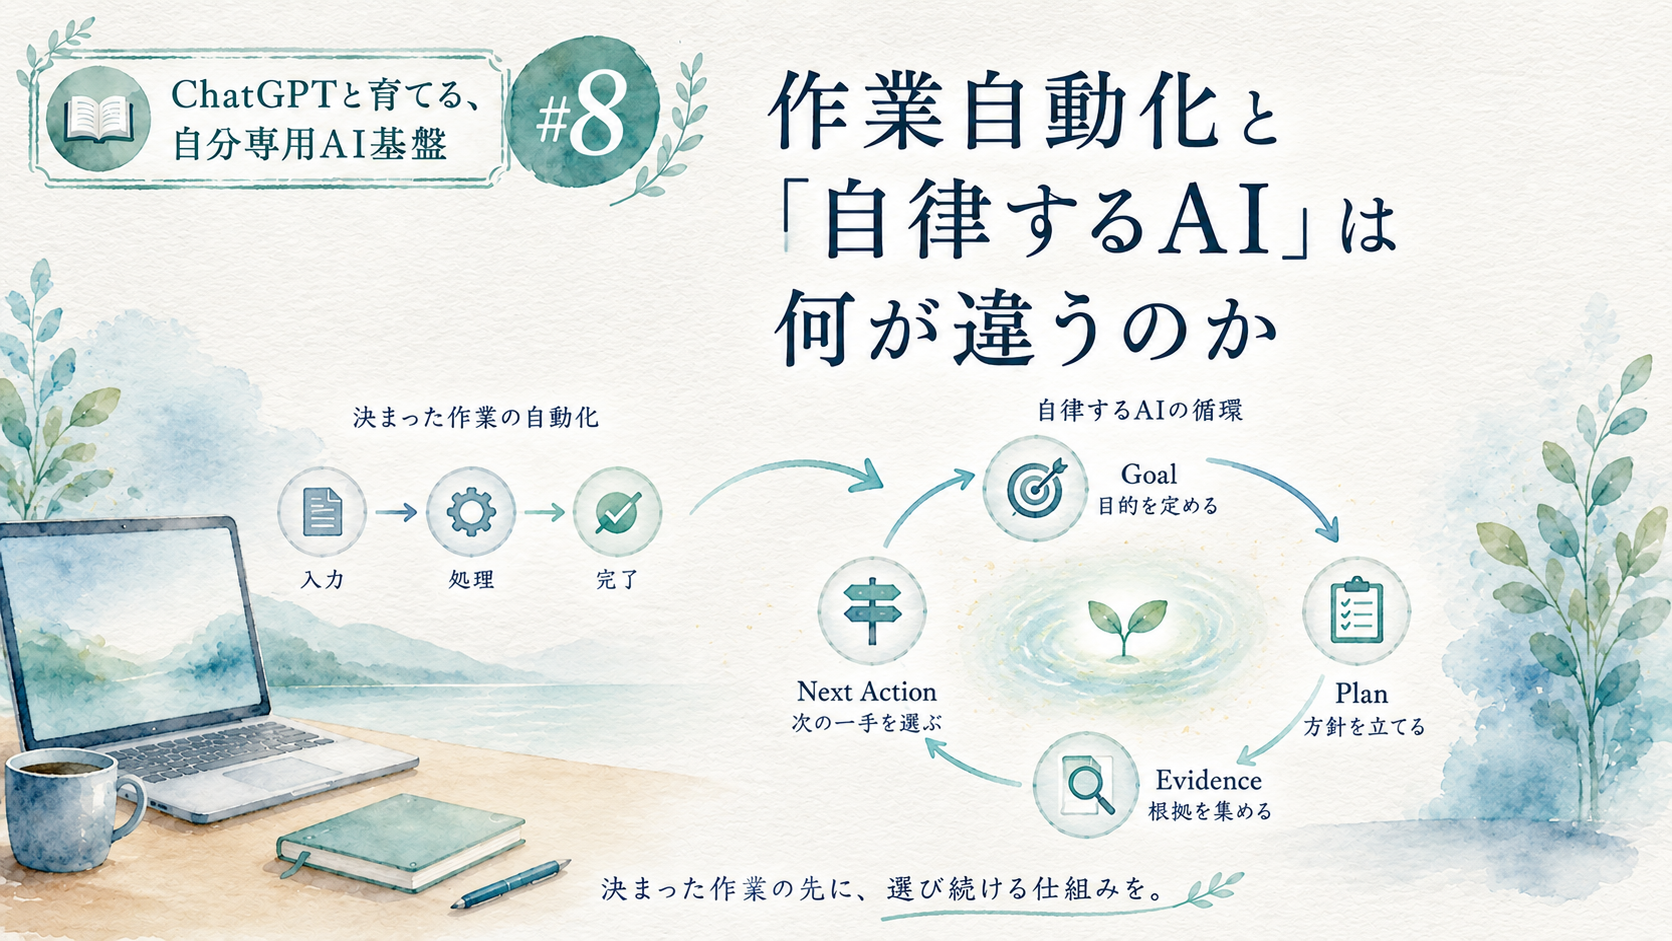
※「ChatGPTと育てる、自分専用AI基盤」第8回です。
前回は、ChatGPTやサービスが途中で止まっても仕事そのものを失わないよう、ChatではなくRunを仕事の正本にし、Event、Checkpoint、pause / resume、leaseを持たせた話を書きました。
→ 第7回:AIが途中で止まっても、続きを再開できるようにした
Runがdurableになると、長い仕事を途中から続けられます。
ただし、ここで一つ疑問が残ります。
途中から再開できることと、自分で次の行動を選べることは同じではありません。
決められた処理を順番に実行するだけなら、n8nやcron、普通のWorkerでもできます。
では、私がLoop Engineで作ろうとしていた「自律するAI」は、それと何が違うのか。
この違いを実装しながら整理していったのが、第8回の話です。
- 自動化は「道順が決まっている仕事」に強い
- 自律性は「次の一手を選ぶ」ところにある
- PlannerとEvaluatorを分けた理由
- AIが「成功した」と言っても成功扱いしない
- 逆に、AIに考えさせなくてよい処理は外した
- 「Autonomous mode」は万能権限ではない
- HOST_DRIVENでも、自律的なLoopの構造は作れる
- 有料の自律Reasonerは、最初からONにしなかった
- 0.10ドル上限の自律開発rehearsalまで設計した
- 自律化しても、人間の承認境界は残る
- 自動化と自律化の違いを、今はこう考えている
- 振り返ると、「自由にする」のではなく「選べる範囲を作った」回だった
- 次に起きた問題は、AIが一人ではなくなったことだった
- 第9回:複数のChatGPTに同じシステムを開発させたら、普通に衝突した
- 連載ナビ
- 関連記事
自動化は「道順が決まっている仕事」に強い
自動化という言葉はかなり広いですが、私の環境で最も分かりやすいのはn8nや各種Workerです。
たとえば、
毎朝7時
  ↓
Search Consoleを取得
  ↓
保存
  ↓
集計
あるいは、
Publicationを検出
  ↓
状態を確認
  ↓
一定時間後に再観測
のような処理です。
何をするかが最初から決まっているなら、LLMに毎回考えさせる必要はありません。
むしろ普通のプログラムの方が速く、安く、再現性があります。
この時点で、私の中ではだんだん役割分担が見えてきました。
やり方が決まっている
  → Automation / Worker

やり方がまだ分からない
  → Loop Engine
Loop Engineを「何でも自動で実行する装置」にしたかったわけではありません。
答えの道筋が最初から決まっていない仕事を、試行錯誤しながら進める装置にしたかったのです。
自律性は「次の一手を選ぶ」ところにある
Loop Engineでは、Runの最初に少なくとも、
- Goal
- Success Criteria
- Constraints
- Budget
を持たせます。
そして一回の処理は概念的に、
Goal
  ↓
Plan
  ↓
Execute
  ↓
Evidence
  ↓
Evaluate
  ↓
Next Action
  ↺
と進みます。
ここで重要なのは、Next Actionが最初から固定されていないことです。
テストに失敗したら、原因を見て修正案を変える。
Evidenceが足りなければ追加で調べる。
Success Criteriaを満たしていれば終わる。
同じ失敗を繰り返して進展がなければ、別の方法へ切り替えるか停止する。
つまり、自律性を「人間がいないこと」と定義するのではなく、
Goalと制約の範囲内で、現在のEvidenceを見て次のbounded actionを選べること
として考えるようになりました。
PlannerとEvaluatorを分けた理由
第6回でも少し触れましたが、Loop EngineではPlannerとEvaluatorを分けました。
Plannerは次の一手を考えます。
Evaluatorは、その結果がSuccess Criteriaを満たしたかを判定します。
Planner
  → 何を試すか

Executor
  → 実際にやる

Evaluator
  → 結果は十分か
同じAIが、
「これをやります」
と言った直後に、
「成功しました」
と自己申告するだけでは弱いからです。
そこでSuccess CriteriaとEvidenceを別に持たせ、評価を一段分けました。
ただし、ここでもモデルの判断だけを信用するようにはしませんでした。
AIが「成功した」と言っても成功扱いしない
Autonomous Development Executorを作った時、この点をかなり厳しくしました。
Development Runでは、モデルが単にsuccess=trueを返してもRunを成功にできません。
実際の完了条件として、概念的には次の鎖を要求しました。
- 最後のコード変更がある
- その変更後にQuality Gateを実行する
- exactなjobが
succeededになる - そのjobのlogを読む
- logに
quality_gate_status=passedがある - 検証後にcommitする
- exactなHEADが承認済みpush境界を通る
- その後のEvaluatorもSuccess Criteriaを満たす
つまり、
AIが成功だと思うこと
と、
システム上、本当に成功条件を満たしたこと
を分けました。
これは第5回のPublishing MCPで、「APIが200 OKを返した」だけでは公開成功とみなさず、WordPressやBufferからread-backしたのと同じ考え方です。
AIを自律化するほど、自己申告ではなく外部Evidenceが重要になりました。
逆に、AIに考えさせなくてよい処理は外した
自律化というと、全部をAIに考えさせる方向へ進みそうですが、実際には逆の設計もかなり増えました。
分かりやすい例がQuality Gate待ちです。
pytestやRuff、mypyを投入したあと、jobが終わったか5秒ごとに確認する。
これは「思考」ではありません。
そこで、
- job status polling
- terminalになった後のlog取得
quality_gate_status=passedの確認
は決定論的処理としてWorker側へ寄せました。
この待機ではモデルtokenもAPI費用も使わず、Loopのiteration数にも入れません。
失敗したlogが返ってきた時だけreasonerへ戻し、原因を考えさせます。
考える必要がある
  → Reasoner

決まった確認だけ
  → Worker / deterministic code
これはかなり大事な方針になりました。
自律AIを作ることと、LLMを何にでも使うことは別です。
「Autonomous mode」は万能権限ではない
Loop EngineにはautonomousというOperating Modeがあります。
ただ、この名前は少し危険です。
「autonomous」と聞くと、何でも自由にやるAIを想像しやすいからです。
私の設計では、そうしませんでした。
Capabilityにはriskを持たせます。
たとえば、
- read_only
- reversible_write
- externalsideeffect
- privileged
です。
さらにDevelopment側では、後に、
Tier 0
  → 隔離されていて戻しやすい。Run開始時にまとめて委任

Tier 1
  → 外部状態を変える。Chatで明示承認してから実行

Tier 2
  → secret、root trust、不可逆変更など。人間ローカル操作
という形へ整理しました。
上位原則は、
「戻せるものはAI。戻しにくいものは人間。」
です。
自律性を高めるために人間を全部消すのではなく、安全に失敗できる領域を広げ、その範囲だけAIへ委任する方向へ進めました。
HOST_DRIVENでも、自律的なLoopの構造は作れる
ここで少しややこしいのですが、「自律するLoop」と「サーバー側で有料LLM APIを常時動かすこと」も別です。
初期のLoop Engineでは、ブラウザ版ChatGPTをPlanner / Evaluatorとして使うHOST_DRIVENを基本にしました。
Loop Engine
  ↓ planが必要
ChatGPT
  ↓ bounded action
Loop Engine
  ↓ actionを実行
Evidence
  ↓ evaluationが必要
ChatGPT
  ↓ 評価
Loop Engine
つまりReasoning主体がブラウザ側でも、
- Goal
- Run state
- Plan
- Capability
- Evidence
- Evaluation
- Next Action
の構造は成立します。
逆に言えば、APIをサーバーに置いたから自律的になるわけではありません。
自律性はモデルの置き場所ではなく、仕事の状態と次行動選択の構造にあると考えるようになりました。
有料の自律Reasonerは、最初からONにしなかった
server-side Reasonerを設計した時も、最初から常時ONにはしませんでした。
Loop Engineには、
- RunごとのAPI cost cap
- platform全体の月間budget
- paid reasoning用のglobal lease
- spend reservation
- paid autonomy kill switch
を入れました。
そして@@INLINE0@@のdefaultは@@INLINE1@@です。
API keyが存在するだけでも有効になりません。
Phase 4の実機rehearsalでは、HOSTからpaid APIへhandoffしようとしてもprovider / keyが未設定なら拒否され、active reasonerはhostのまま、API costは0ドルでした。
Phase 6ではさらに、kill switchが閉じている限り、advance_autonomous_runやbackground autonomous workerそのものを動かさないようにしました。
「自律化の機能を作った」と「常時自律実行を許可した」を分けています。
0.10ドル上限の自律開発rehearsalまで設計した
その後、server-side Reasonerを本当に試すため、固定された低コストrehearsalも作りました。
上限は0.10 USDです。
このrehearsalでは、
- 専用のisolated Development Workspaceを作る
- reviewed delegation profileだけを使う
- write → Quality Gate → fix → commitまで進める
- exactなpush approval actionまで到達する
ところまでを対象にしました。
ただし、そこで止めます。
rehearsal自身は、
- pushを承認しない
- mergeしない
- deployしない
- publishしない
- privileged actionを実行しない
ように固定しました。
また、この機能を実装した時点のsource validationでは、実際のAPI keyもpaid API requestも使っていません。
つまり、ここでも「自律できる能力を作った」からといって、すぐに本番で自由に動かしてはいません。
まず小さく囲い、費用も権限も固定し、どこまで安全に任せられるかを試す。
この順番にしました。
自律化しても、人間の承認境界は残る
Autonomous Developmentのstate machineを設計すると、かなり長い処理をAI側へ寄せられます。
概念的には、
要件を読む
↓
workspaceを確保
↓
plan
↓
edit
↓
test
↓
evaluate
↓
必要なら修正して再試行
↓
quality gate
↓
commit
まではTier 0として進められる。
でも、その先の、
push
PR merge
candidate deploy
では承認境界を残します。
ここでRunは消えません。
第7回で作ったdurable stateのおかげで、approval待ちのまま停止し、後から別Chatで続きを再開できます。
つまり第7回のRun / Checkpoint / Resumeがあったから、第8回のbounded autonomyを安全に伸ばせました。
この境界は後にさらに整理しました。毎回同じ「承認します」で止めるのではなく、安全で可逆でscopeが決まったroutine作業は次の本当のprotected boundaryまで進める。一方、secret・root・不可逆なproduction操作・目的変更などは人間へ戻す形です。
→ 第10回:AI開発のたびに「承認します」と打つのをやめた
そして、本当に人間が必要な境界では人間を残したまま、承認入力だけを軽くするApproval UIを追加しました。ボタンはOwner intentを送るだけで、実行権限・policy・live-state再検証はサーバー側に残します。
→ 第11回:AIに「承認」ボタンを作った。でも、ボタンに権限は渡さなかった
自動化と自律化の違いを、今はこう考えている
ここまで作ってきて、私の中ではだいたい次のように整理しています。
Automation
  → 手順が決まっている
  → 同じ入力なら同じ処理を繰り返す
  → 安く・速く・確実に実行する

Autonomous Loop
  → GoalとSuccess Criteriaがある
  → 現在のEvidenceを見て次の一手を選ぶ
  → 試行錯誤する
  → 必要なら止まる・承認を待つ
  → 解法が固まったらAutomationへ降ろす
Loop Engineの役割は、定型作業を永遠にLLMで回すことではありません。
むしろ、
未知の解法を探索して、解き方が分かったら安いAutomationへ変える
ことです。
たとえばSearch Consoleを毎朝読むだけならWorkerでよい。
でも、
「なぜクリックが落ちたのか」
「どのページを直すべきか」
「新しい分析機能が必要ではないか」
は、最初から固定手順では解けません。
そういう部分をLoopへ載せる。
この役割分担が、後のPersonal AI Platform全体の設計にもつながっていきます。
振り返ると、「自由にする」のではなく「選べる範囲を作った」回だった
自律AIという言葉には、どうしても「勝手に何でもやる」という印象があります。
でも、自分が実際に作った方向はほぼ逆でした。
- Goalを固定する
- Success Criteriaを固定する
- Capabilityを限定する
- riskを分類する
- budgetを固定する
- Evidenceを要求する
- deterministic guardを置く
- 承認が必要な境界を残す
- staleなら止める
- no-progressなら止める
その上で、許可された範囲内の次の一手だけをAIに選ばせる。
自律性を上げるほど、外側の制約も増えました。
「AIを自由にした」のではなく、
AIが安全に選べる空間を設計した
と言う方が近いと思います。
次に起きた問題は、AIが一人ではなくなったことだった
一つのRunが自分で次の行動を選び、途中で止まっても再開できるようになると、次はもっと仕事を並列に進めたくなります。
複数のChatGPTを開く。
別々の機能を同時に開発する。
複数のworkspaceで作業させる。
当然、速くなります。
そして当然、普通に衝突しました。
同じmainを見ている。
同じファイルへ触ろうとする。
片方が進めたことで、もう片方の前提が古くなる。
この続きとして、複数Chat / workspace / live state / leaseを使い、並列開発をどう成立させていったかを第9回にまとめました。
第9回:複数のChatGPTに同じシステムを開発させたら、普通に衝突した
Workspace isolation、component lease、shared mutation serialization、live state、さらに別Chatの仕事を勝手に継続しないownership boundaryまで必要になった経緯を扱っています。
→ 第9回:複数のChatGPTに同じシステムを開発させたら、普通に衝突した
連載ナビ
- 第1回:ChatGPTに長期記憶が欲しくて、Knowledge MCPを作った
- 第2回:ChatGPTにコードを書かせるだけでは足りなかった。Development MCPを作った
- 第3回:AIに自分自身を再起動させたら止まった。Development Runnerを分離した
- 第4回:ChatGPTからPRを作り、安全にマージできるようにした
- 第5回:記事を書くだけでは自動化にならなかった。Publishing MCPを作った
- 第6回:MCPをいくつ作っても、AIは自律化しなかった。そこでLoop Engineを作った
- 第7回:AIが途中で止まっても、続きを再開できるようにした
- 第8回:作業自動化と「自律するAI」は何が違うのか ← 今回
- 第9回:複数のChatGPTに同じシステムを開発させたら、普通に衝突した
- 第10回:AI開発のたびに「承認します」と打つのをやめた
- 第11回:AIに「承認」ボタンを作った。でも、ボタンに権限は渡さなかった
- 第12回:記憶から並列開発まで。自分専用AI基盤は、いったんここまでできた
- 連載一覧

コメント